大模型实训经验:拒绝采样
本文适合大模型训练初学者。 受实验资源限制,部分消融实验尚不完整,结论中也包含主观推理。 欢迎在评论区友善讨论。
拒绝采样
在大模型训练中,大家经常听到 SFT 和 RL,尤其是近两年,RL 算法成为关注的焦点。 在这些训练方法背后,有一个值得关注的思想——“拒绝采样”:生成候选,再筛选出适合学习的样本。 今天,我想从自己有限的大模型实训经验出发,聊一聊拒绝采样为什么重要,以及怎样拒绝可能更有帮助。
如果直接搜索“拒绝采样”,你会看到很多从统计学角度解释它的文章;这里讨论的是大模型训练中生成候选并筛选数据的做法,并不等同于统计学中严格定义的拒绝采样算法。 用一个生活中的例子来说,小明第一次打篮球,完全不知道怎样才能把球投进篮筐,于是按照自己的想法投了 10 次:其中 6 次很糟糕,三不沾;3 次还可以,碰到了篮板;还有 1 次运气很好,球进了。 于是,他开始强化那几次较好投篮的手感。 在这个例子中,可供学习的样本有 10 条,但他选择了其中较好的 4 次;换一种说法,他采样了 10 次,保留了 4 次,拒绝了 6 次。
在大模型中,拒绝采样广泛用于准备 SFT 数据 [1]。 例如,可以让模型针对每个任务 rollout 多次,保留每次的轨迹,随后通过参考答案或基于规则的验证器(verifier)打分,拒绝低分轨迹,保留高分轨迹用于 SFT。
初学者可能会有一个疑惑:如果一个任务本身有答案,为什么不让模型直接学习答案呢? 原因有很多:
- 首先,可能只有答案,没有解答过程,也没有思维链(CoT);这样学习更像是在背答案,对推理能力的帮助可能有限。
- 其次,即使有解题步骤,这些步骤也未必适合当前模型,学习后不一定能独立复现推理。 生活中的一个例子是,高中做数学题时,有些试题提供了完整的分步骤解答,我看下来觉得每一步都没问题,但让我从头独立解决,却发现做不出来。 这是因为分步骤的解答是思考的产物,并不一定完整呈现思考本身。 我需要知道这些步骤是如何被想出来的,才能进步。
因此,一种有用的办法是让模型自己做一遍;如果一遍做不对,就做多遍,可能有一次是对的,然后学习这次成功轨迹中呈现的完整推理过程。
看到这里,你可能会想到:这不是和 GRPO [2] 这类强化学习算法很像吗——让模型先自己做多次,再比较哪些轨迹更好,并加强相应行为? 事实上,拒绝采样后进行 SFT,与 on-policy RL 都可以利用模型自身生成的轨迹和验证器的评价信号。 自身生成的轨迹往往更贴近当前模型的行为分布,而筛选或奖励信号则帮助模型提高好行为的概率。 但两者的训练目标不同:拒绝采样加 SFT 通常只模仿保留的轨迹,而 GRPO 等 RL 方法还会利用相对奖励调整策略,并不只是丢弃低分轨迹。
拒绝采样加 SFT 与 on-policy RL 的另一个差别在于采样与模型更新的频率。 前者一般先准备一批数据,少则几百条,多则上万条,再用于训练;训练过程中,数据仍由旧策略模型产生,随着模型更新,这批数据与当前策略之间可能逐渐产生偏移 [3]。 后者通常更频繁地交替采样与更新,使训练数据更贴近当前策略,但也可能在多次更新中复用近期采样的数据。 举个例子,如果我有 100 套试卷,可以选择一次性做完所有试卷,再结合答案查漏补缺。 也可以做一套、改一套,分析学习后,再开始下一套。
当然,在依赖成功轨迹或稀疏终局奖励时,拒绝采样和 RL 都需要有机会采到有价值的结果。 如果尝试 100 次都做不对,按正确性筛选可能会把轨迹全部拒绝;RL 也可能因为奖励过于稀疏而难以获得有效的学习信号。 在这种情况下,它们更擅长把低概率做对的事情变成高概率做对,而很难仅靠这样的采样与反馈学会几乎从未成功过的任务。 关于如何为这类任务创造学习机会,可以参考“课程学习”相关的知识,本次不展开讨论。
左脚踩右脚(吗)
很多人会觉得,让模型自己先做多遍,把做得好的保留下来训练,能力就可以越来越强;这个过程中没有借助其他模型,整个系统好像没有额外信息输入,那是不是“左脚踩右脚升天”?
我觉得并不是,因为这里有一个很关键的组件被忽视了:verifier。 这一切成立的前提是,verifier 能够依据可靠、可验证的标准评价每条轨迹,并给出有足够区分度的奖励(reward)。 这里有两个关键:一是可验证,二是区分度。 两者缺少其一,都可能导致无法有效筛选。
关于可验证性,举个例子:让一个模型尝试 100 次探索宇宙起源假说,再从中挑选较好的进行学习;如果缺乏可验证的评价标准,我们就很难可靠地判断哪些假说更好,筛选也缺少可信的学习信号。
关于区分度,举个例子:让一个模型对一道已经掌握的四则运算题计算 100 次,再从中挑选较好的进行学习。 如果大多数结果都正确,且只按最终答案是否正确打分,就没有多少区分度,被拒绝的和留下的也可能差不多。
做过 benchmark(例如 ResearchClawBench [4])的同学应该会感同身受:找到既可验证、又有区分度的答案或 verifier,非常困难。 很多时候,要么所有被评测的模型都能完成任务,模型之间没有区分度;要么模型确实做不对,但最后发现是任务本身不可解。
所以,在拒绝采样过程中,verifier 虽然没有直接提供完整解法,却通过评价带来了额外信息,而构建它本身也需要很强、很难获得的知识。 拒绝采样并不完全是模型自身能力的涌现,也可以看作模型对 verifier 评价标准的一种“变相蒸馏”。
如何拒绝
那么,怎样拒绝才能更好地训练模型? 假如我有 100 个任务,每个任务让模型做 10 遍,就得到了 1,000 个样本。 这些样本经过打分后,每个都有一个分数,接下来就要选择拒绝哪些样本。
首先,可以筛选每个任务的 10 个样本。 对于同一个任务,我们通常学习得分较高的几条,拒绝低分轨迹,这很容易想到。 但进一步想,100 个任务是否都有必要学习? 有些任务很难,10 次尝试都是低分,看起来应该拒绝。 但如果 10 次都是高分,说明任务很简单,模型已经掌握,似乎也可以减少这类数据。
进一步想,有两个维度共同影响一个样本的得分:任务难度和模型表现。 我们可以用横坐标表示任务难度,用纵坐标表示模型表现,以原点(0,0)表示一般难度和一般表现。 这样,所有样本就被分到了四个象限:
- 第一象限:任务难度高,模型表现好。 就像考试中做出了最后的压轴题。
- 第二象限:任务难度低,模型表现好。 就像考试中做对了简单的选择题。
- 第三象限:任务难度低,模型表现差。 就像考试中做错了简单的选择题。
- 第四象限:任务难度高,模型表现差。 就像考试中没做出最后的压轴题。
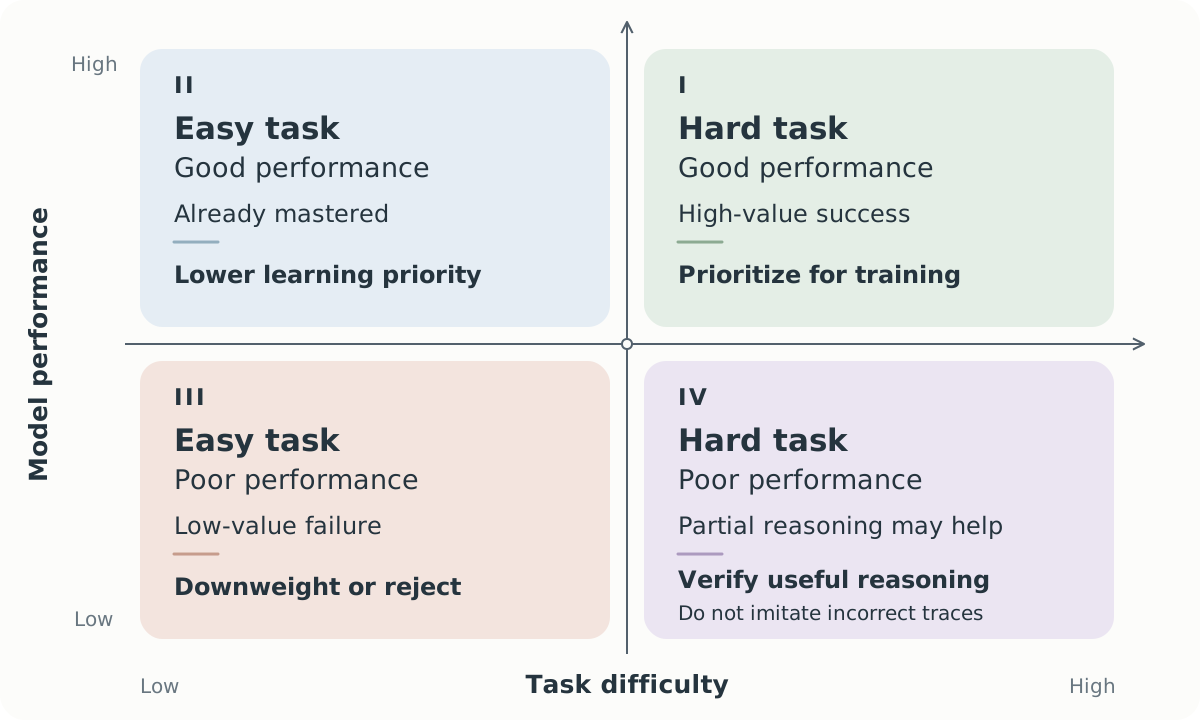
图 1:任务难度与模型表现的定性划分,中心表示一般难度和一般表现。
总体来说,我们希望保留第一象限的样本用于训练,因为这些任务难,模型表现又好,很值得学习和强化。 同时,我们希望尽量减少第三象限的样本,也就是任务简单,但模型没有发挥好,仍然做错。 至于第二和第四象限,则分别对应简单任务做对、困难任务做错,属于相对常见的情况,是否学习可以视具体情况决定。
可能有人会疑惑:困难任务做错了,为什么还需要学? 事实上,对于一个困难任务,模型的轨迹不一定全部错误,其中可能包含有价值的思考;如果能验证并提取这些有用部分,仍可能有学习价值,但不应把整条错误轨迹当作正确解法模仿。
总体来说,我们已经有了目标:尽量保留第一象限的样本,拒绝第三象限的样本。
那么,如何区分这些样本?
模型表现好比较容易判断,例如样本得分高于某个阈值(如第 75 百分位数)。 那么,难度用什么衡量? 每个任务多次 rollout 得分的标准差,可以在一定程度上反映模型在这个任务上的不稳定性,作为对当前模型而言具有学习价值的难度代理。 标准差是方差的平方根;对于相同的一批得分,两者对任务波动程度的排序一致。 简单任务多次尝试的结果通常相近,标准差较小;有些较难的任务,模型有时能完成、有时不能,这类任务可能更值得学习。 当然,过难的任务如果多次都无法完成,得分标准差也可能很小,因此它不能直接等同于任务的绝对难度。
为了观察得分标准差与任务难度的关系,我做了下面的可视化。 分析对象是 GLM-5.2,对比基线是 Opus 4.8。 在这批任务中,对于简单任务,两个模型都可能完成;对于较难的任务,Opus 4.8 可能与 GLM-5.2 拉开差距。 横坐标表示筛选阈值:先让 GLM-5.2 对每个任务各完成 4 次,计算得分标准差,再按不同阈值筛选任务。 例如,x = 0.5 表示拒绝得分标准差小于 0.5 分的任务。 纵坐标表示筛选后的任务中,Opus 4.8 的得分比 GLM-5.2 的 4 次平均分至少高出指定分差的任务比例,不同曲线对应不同的分差门槛。 例如,“gap ≥ 2%”这条线表示 Opus 4.8 至少高出 2 分的任务占比;这里的得分已归一化到 0–100,图中的“%”按这个量表理解。
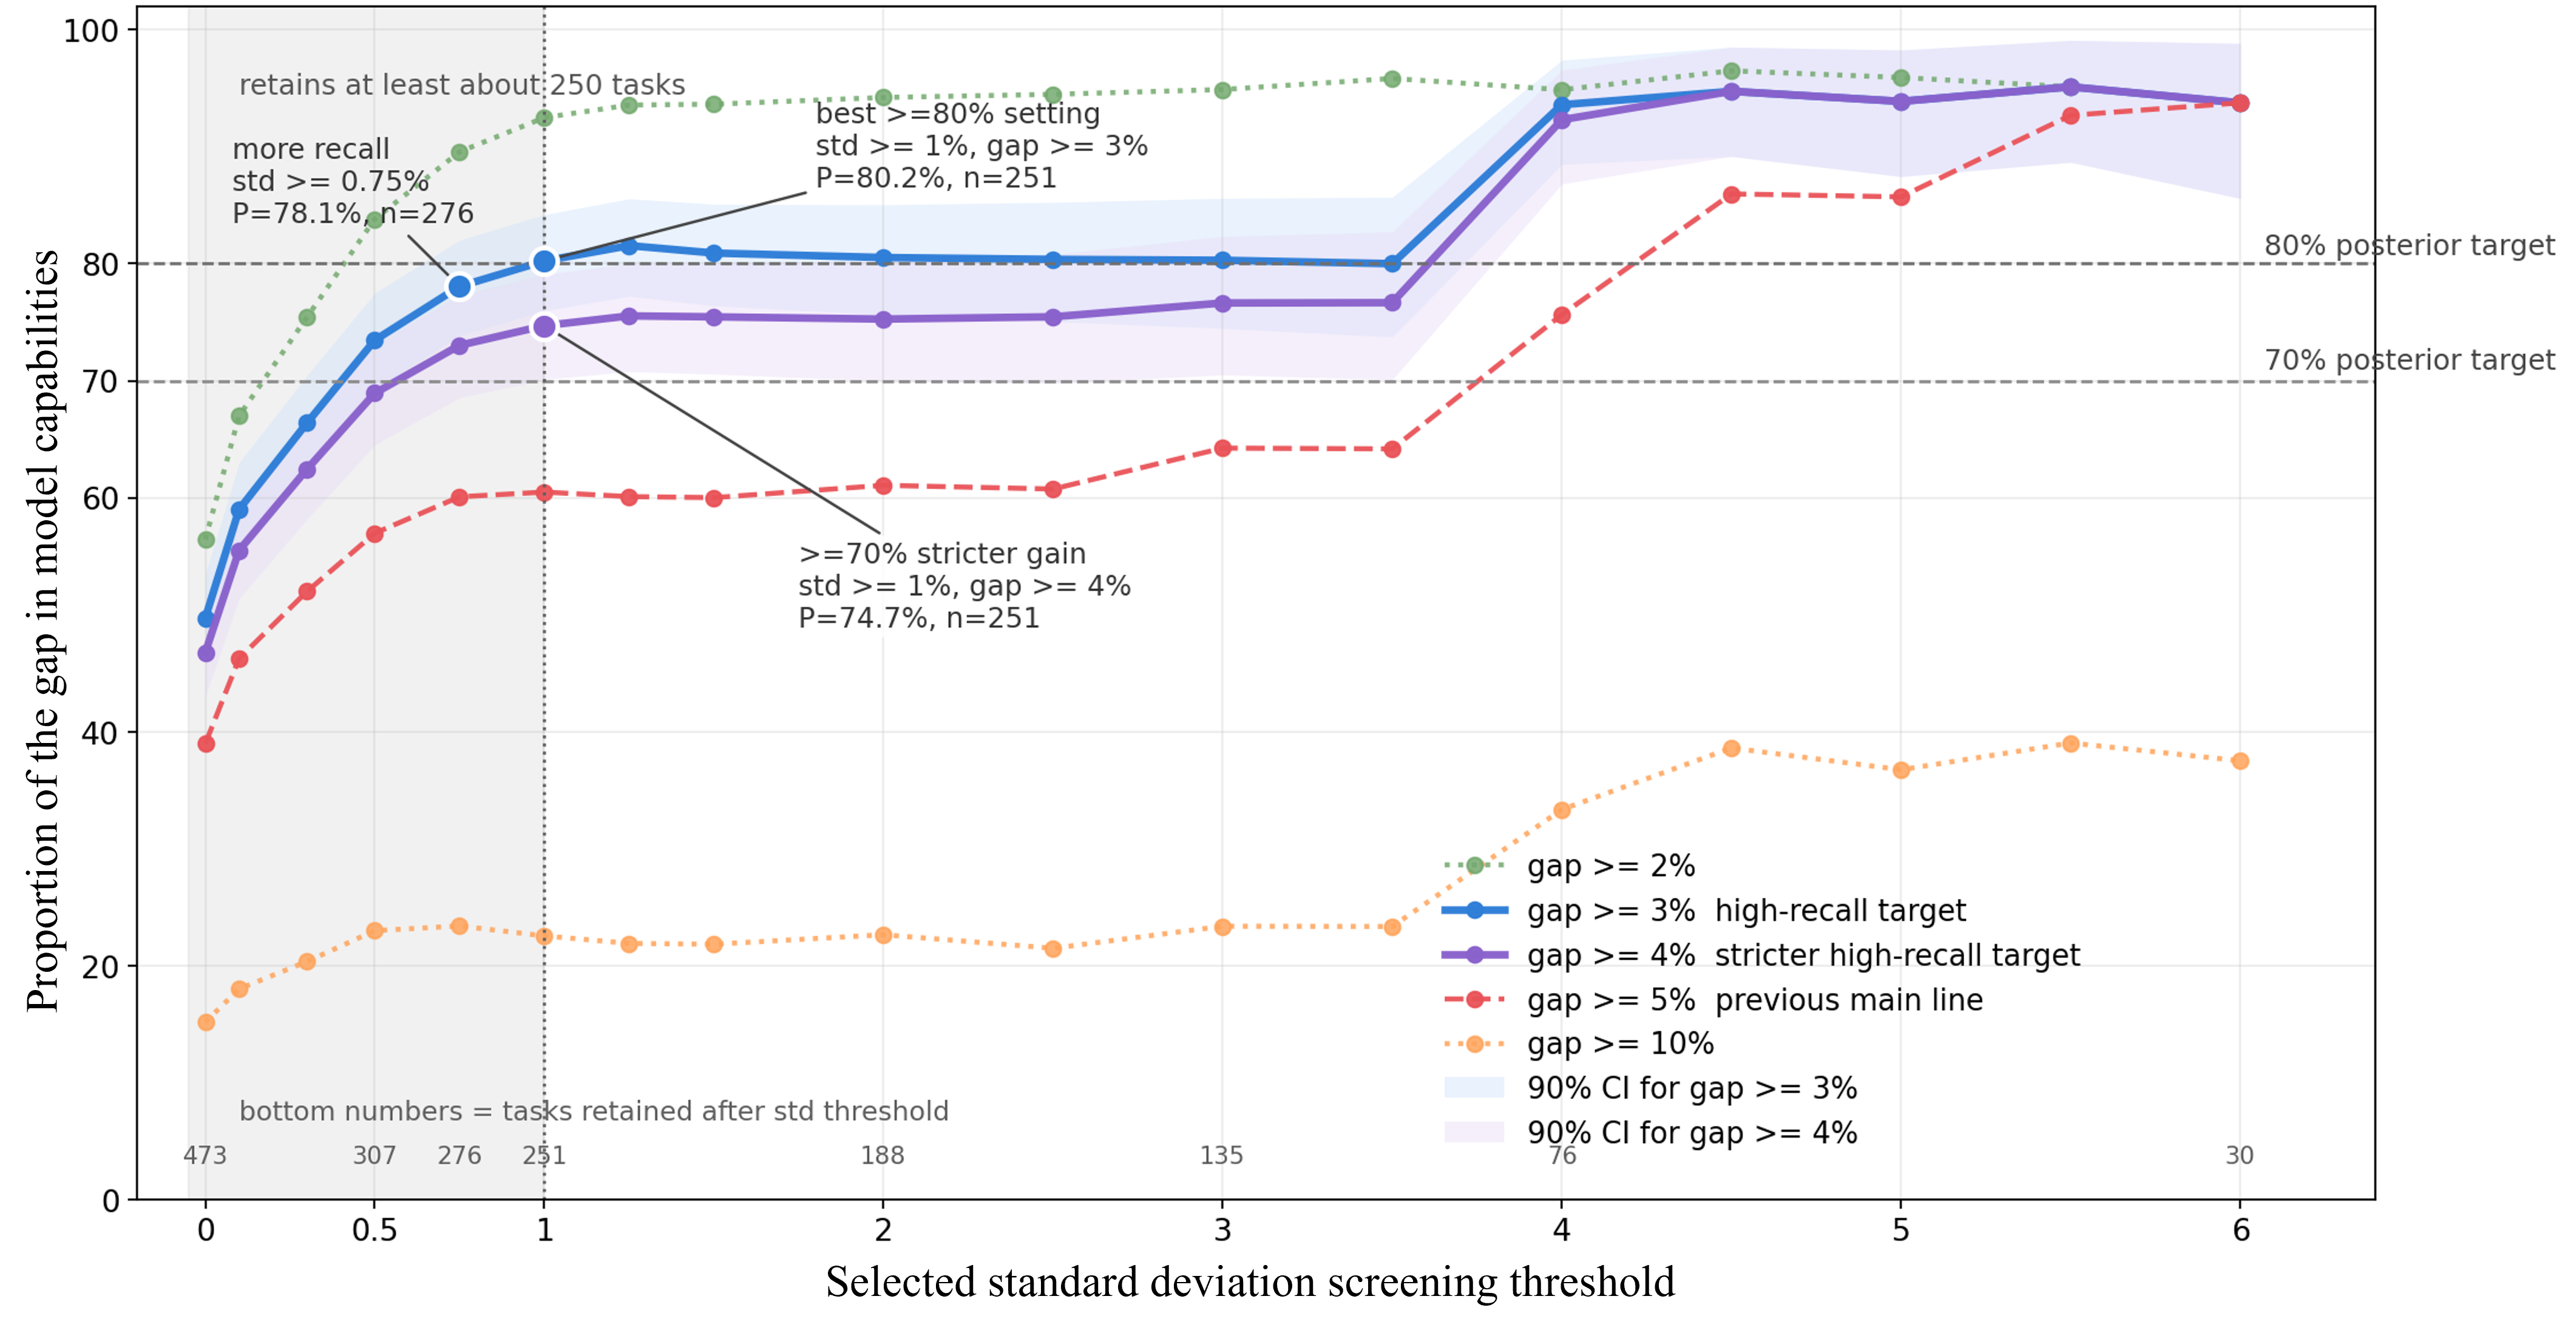
图 2:标准差阈值、保留任务数量与模型分差的关系;阴影表示相应曲线的 90% 置信区间。
可以看到,各条曲线总体呈上升趋势,但并非严格单调。 换言之,在得分标准差较高的任务中,Opus 4.8 比 GLM-5.2 至少高出指定分差的比例通常更高。 当然,筛选阈值过高会拒绝过多任务,导致可用训练样本太少。 在这张图中,保留标准差大于或等于 1 分(图中记作 1%)的任务,是一个较合适的折中,对应白边圆点标注的位置。 拒绝标准差小于 1 分的任务后,共剩下 251 个任务,其中 80.2% 的任务上,Opus 4.8 比 GLM-5.2 的 4 次平均分至少高出 3 分。 这说明,在本次实验中,筛选后的任务更能区分这两个模型,也支持将得分波动作为难度代理的做法。
备注: 这里的分析仅针对私有构造任务,不能代表这两个模型的综合能力。
训练验证
在 MLE-bench Lite [5] 上,我比较了以下三种设置:
- 原始 Qwen 3.8 27B 模型。
- 使用 Qwen 3.8 27B 对 2,000 个训练任务各 rollout 3 次,每个任务保留最好的一条轨迹,得到 2,000 条训练样本后进行训练,也就是只筛选模型表现好的样本。
- 先从上述任务中筛选出得分标准差最大的 600 个任务,再为每个任务保留最好的一条轨迹,使用这 600 条样本训练。
训练结果表明,在本次实验中,基于模型表现的拒绝采样提升了模型性能;进一步拒绝得分标准差较小、区分度较低的任务后,仅使用 30% 的数据,反而取得了更好的效果。 这表明,基于得分波动的任务筛选,有助于进一步挑选更高质量、更有价值的训练数据。
虽然在 AI 领域,少量高质量数据的训练效果优于大量质量参差不齐的数据,并不是什么新鲜事,但当我自己在实验中观察到时,还是很惊讶。 而且数据量的差距很大:仅用 30% 就实现了反超。
表 1:Qwen 3.8 27B 在 MLE-bench Lite 上的结果;Human rank 为归一化指标,数值越大越好。
| 训练设置 | Human rank ↑ |
|---|---|
| 1:原始 Qwen 3.8 27B(本次 SFT 前) | 0.668 |
| 2:SFT:每个任务保留最佳轨迹(2,000 条样本) | 0.693 |
| 3:SFT:得分标准差最高的 600 个任务各自的最佳轨迹 | 0.723 |
人生哲理
人生也需要拒绝采样。 如果好的、坏的什么都学,什么都不拒绝,很可能误入歧途。 如果只学习好的,却不筛掉过于简单的内容,会有进步,但可能有些慢。 如果拒绝那些坏的和过于简单的内容,转而学习有难度、有挑战的内容,或许会进步得更快。